6.6.2. Qwen3.8模型样例运行
下面以Qwen3.8模型为例,详细介绍如何从零开始在Docker环境中完成环境配置与安装部署,并完整跑通量化、编译和推理演示流程。
备注
后摩大模型样例包支持Qwen模型多个规格。本文以Qwen3.8-27B模型为例进行说明。其他模型规格的运行命令和高级参数,参看样例目录下的 README.md 文件。
本文提供以下两种使用方式:
运行方式说明如下:
运行方式 |
适用场景 |
主要流程 |
|---|---|---|
快速入门 |
适用于首次验证设备、驱动和推理环境是否正常,或希望快速体验 Qwen3.8-27B 模型推理效果的用户。 |
准备推理环境 → 下载编译后模型 → 运行推理演示与性能评测 |
完整开发流程 |
适用于需要从开源模型开始完成模型量化、编译和推理验证的用户。 |
准备开发环境 → 下载开源模型 → 量化模型 → 编译模型 → 运行推理验证 |
6.6.2.1. 模型推理验证
执行下面步骤运行Qwen3.8-27B样例,并完成推理演示和性能评测:
进入示例包
houmo-examples-xh2目录,使用env.sh配置样例运行环境。cd houmo-examples-xh2 source env.sh
进入模型目录:
cd models/llm/qwen3.5
下载Qwen3.8-27B模型文件:
python3 get_model.py --type hmm --model_name qwen3.8 --model_size 27b
执行成功后,
qwen3.8-27b_prefill.hmm、qwen3.8-27b_decode.hmm、qwen3.8-27b_visual_m96.hmm、qwen3.8-27b_visual_m96.codegen.json等文件以及hmquant/quant_embedding.pt文件将下载至当前工作目录下的output/xh2路径中。推理模型。通过
demo.py脚本,启动模型的标准推理:python3 python/demo.py --model_name qwen3.8 --model_size 27b
qwen3.8-27B的推理示例图片存放在示例包
houmo-examples-xh2/data/pic/beach.jpeg路径,推理示例图片如下所示: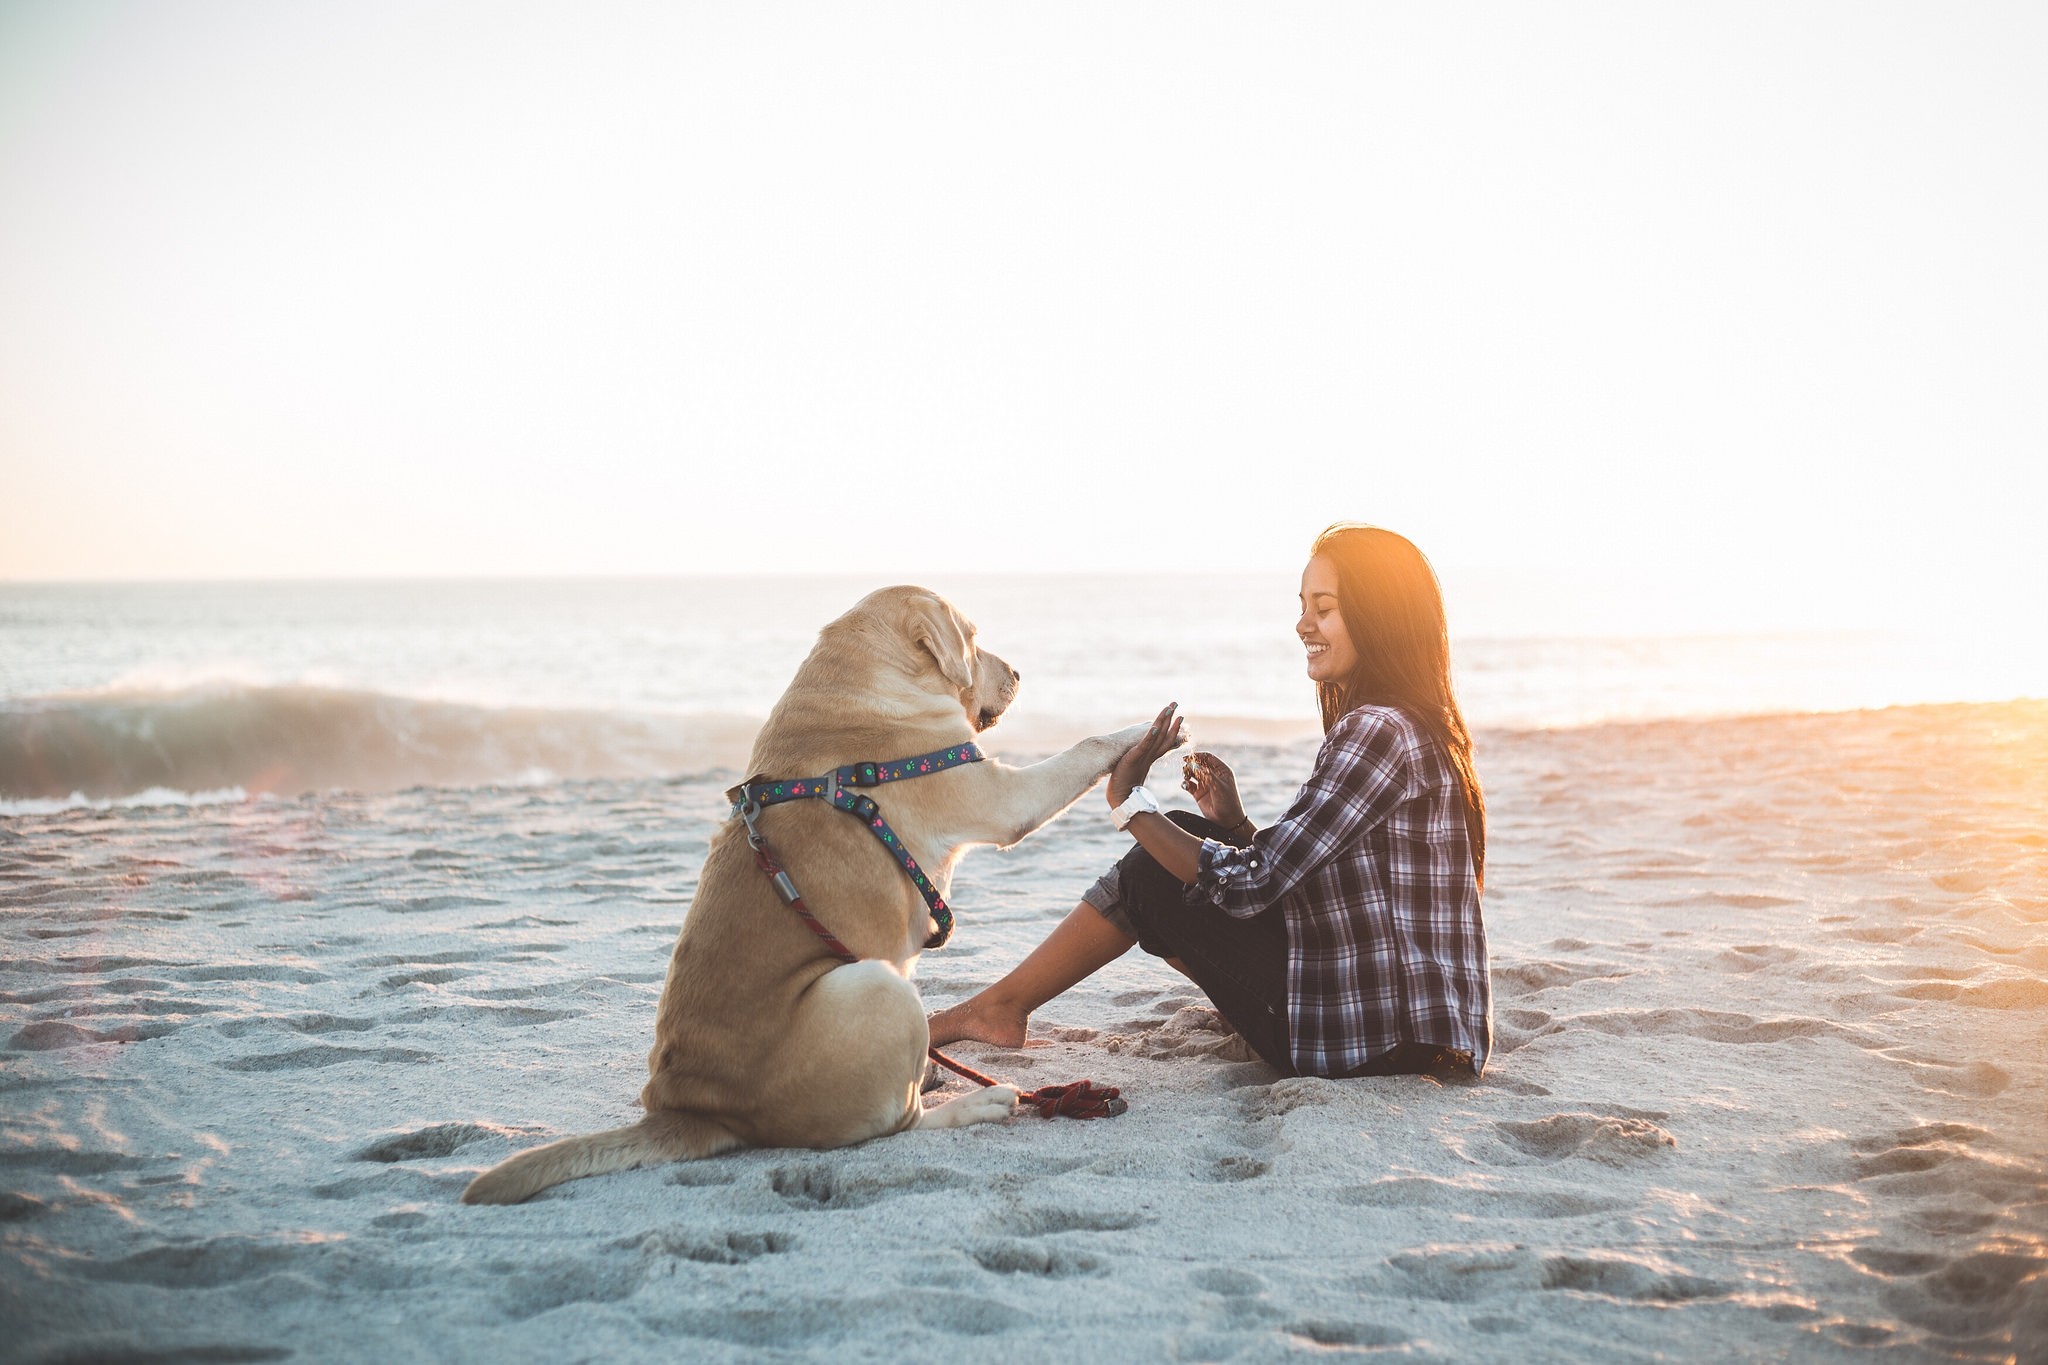
执行成功后,终端将返回提示信息,示例如下:
[2026-09-07 09:12:31.222] [tid 63] [warning] Using TCIM_BACKEND = Xh2HalBackend as default backend
[2026-09-07 09:12:31.222] [tid 63] [warning] Empty backend name, use Xh2HalBackend instead.

Q: 描述这些图片
A: 这张图片捕捉了一个温馨而宁静的瞬间,发生在一片沙滩上,背景是平静的海面和柔和的日落(或日出)光线。

**主要元素描述:**

1.  **人物与宠物:**
    *   一位年轻女性坐在沙滩上,面带灿烂的笑容,侧对着镜头。她留着深色长发,身穿一件黑白格子衬衫和深色裤子,赤脚。
    *   她身旁坐着一只浅黄色的拉布拉多犬(或类似品种),戴着一条带有彩色图案的胸背带。狗狗也面向女子,伸出前爪,与女轻轻相触,仿佛在“握手”或进行某种互动游戏。
    *   两人/狗之间的互动充满了信任、喜悦和亲密感。

2.  **环境与氛围:**
    *   **地点:** 宽阔的沙滩,沙子细腻,有被海浪冲刷过的痕迹。远处是平静的海洋,可以看到轻微的波浪。
    *   **光线:** 图片最显著的特点是温暖的逆光。太阳位于画面右上方,接近地平线,金色的阳光洒在女子的头发、肩膀以及狗,形成了美丽的轮廓光(rim light)。这种光线营造出一种梦幻、温暖、平和且充满爱意的氛围。
    *   **构图:** 人物和狗位于画面中偏右的位置,左侧留出了大片的海面和天空,使画面显得开阔而宁静。焦点清晰地落在人与上。

3.  **情感与主题:**
    *   这张照片传达了人与宠物之间深厚的情感纽带。
    *   它象征着陪伴、快乐、放松和与自然(海滩)和谐共处的美好时刻。
    *   整体感觉非常治愈、积极,让人感受到生活中的小确幸。

**总结来说,这是一张充满温情和诗意的照片,记录了一位女子和她的爱犬在夕阳下的海滩上共享美好时光的动人场景。**
...
模型完成推理后,将输出性能统计信息。
更多详情,请参看 houmo-examples-xh2/models/llm/qwen3.5/README.MD 。
6.6.2.2. 完整开发流程:从开源模型到设备推理
如果需要基于开源Qwen3.8-27B模型重新生成后摩设备可执行模型文件,可执行完整开发流程。
完整开发流程包括开源模型下载、PTQ 量化、模型编译和推理验证,适用于模型适配、参数调优或定制化部署场景。
6.6.2.2.1. 软硬件环境要求
执行完整开发流程前,请确认开发环境满足以下要求:
警告
Qwen3.8-27B 模型规模较大。如果GPU显存或主机内存不足,可能导致量化进程终止、编译失败或出现 OOM(Out of Memory)错误。
项目 |
要求 |
|---|---|
主机架构 |
仅支持在Ubuntu 24.04 x86架构主机上执行模型量化。 |
GPU 显存 |
GPU 需具备至少40 GB可用显存。 |
主机内存 |
编译主机需具备至少64 GB可用内存。 |
GPU 驱动 |
宿主机需安装与CUDA 12.8兼容的GPU驱动。 |
Docker 镜像 |
建议使用软件平台提供的 Ubuntu 24.04 Docker 镜像执行量化、编译和推理操作。 |
后摩设备 |
执行编译后推理验证时,主机需正确连接后摩M50设备,并安装匹配版本的后摩设备驱动。 |
6.6.2.2.2. 开发流程
完整开发步骤如下:
6.6.2.2.3. 准备量化和编译开发环境
执行以下步骤下载并启动 Docker 开发环境。
下载 Docker 镜像。
登录 后摩开发者社区。
在 请先选择板级类别 下拉列表中,选择使用的后摩板级产品。
在版本列表中选择目标版本号。
在 AI 模型类别筛选器、平台架构筛选器 和 操作系统筛选器 下拉菜单中选择对应条件。
找到资源名为部署镜像的下载资源,并选中该资源左侧复选框。量化和编译模型需下载x86_64全功能镜像。
点击 直接下载、wget 链接、批量直接下载 或 wget 批量下载 按钮,下载 Docker 镜像。
导入 Docker 镜像。
在 Docker 镜像所在目录下,执行以下命令:
docker load -i <docker_file>
其中,
<docker_file>为下载的 Docker 镜像文件名。如果导入成功,终端会显示导入后的 Docker 镜像名称,示例如下:
Loaded image: harbor.houmo.ai/toolchain/release:Dadao-docker-xh2-v1.5.0-ubuntu24.04-x86.64
启动 Docker 容器。
启动容器时需将 GPU 映射到容器内,命令示例如下:
docker run -it \
  --gpus all \
  --pid=host \
  -w /hmdd \
  -v "$PWD:/hmdd" \
  --shm-size 64g \
  harbor.houmo.ai/toolchain/release:Dadao-docker-xh2-v1.5.0-ubuntu24.04-x86.64 \
  /bin/bash
如果主机上存在多张 GPU,可根据实际需要指定 GPU ID。
下载应用开发示例包。
下载应用开发示例包到Docker镜像中。
登录后摩开发者社区。
在 请先选择板级类别 下拉列表中选择使用的后摩板级产品。
在版本列表中选择下载的版本号,再在 AI模型类别筛选器 、平台架构筛选器 、操作系统筛选器 下拉菜单中分别选择AI模型类型、平台架构和操作系统,找到资源名为示例代码的下载资源,选中该资源左边复选框。
点击 直接下载、wget链接、批量直接下载 或 wget批量下载 按钮。
执行下面指令解压应用开发示例包。
unzip houmo-examples-xh2_<release>.zip
解压后为
houmo-examples-xh2/文件夹。
配置样例运行环境。
进入模型样例根目录,并执行环境初始化脚本:
cd houmo-examples-xh2/models
source env.sh
6.6.2.2.4. 下载Qwen3.8-27B模型
在 Qwen3.5 样例目录下,执行以下命令下载开源 Qwen3.8-27B 模型文件:
python3 get_model.py --type raw --model_name qwen3.8 --model_size 27b
下载完成后,开源模型文件默认保存在 Qwen3.5 样例目录下的对应模型路径中。
6.6.2.2.5. 量化模型
在Qwen3.5样例目录下,执行以下命令,通过HMQuantool工具完成模型量化:
python3 ptq.py --model_name qwen3.8 --model_size 27b
量化参数说明参看 《HMQuantool量化工具用户指南》。
Qwen3.8-27B模型量化包括权重量化和模型量化。量化后的模型文件和权重文件默认保存在以下目录:
houmo-examples-xh2/models/llm/qwen3.5/output/xh2/hmquant
6.6.2.2.6. 编译模型
完成模型量化后,在Qwen3.5样例目录下,执行以下命令编译模型:
警告
由于Qwen网络模型较大,编译主机必须具备至少64GB的可用内存,否则可能因内存不足导致OOM(Out of Memory)错误,或者模型编译被终止。
python build.py --model_name qwen3.8 --model_size 27b
Qwen3.8-27B模型包含Prefill阶段模型、Decode阶段模型、及 视觉编码器模型,需要分别完成编译。编译完成后,默认生成以下 .hmm 模型文件。编译后的模型文件存放在 houmo-examples-xh2/models/llm/qwen3.5/output/xh2 文件夹下。